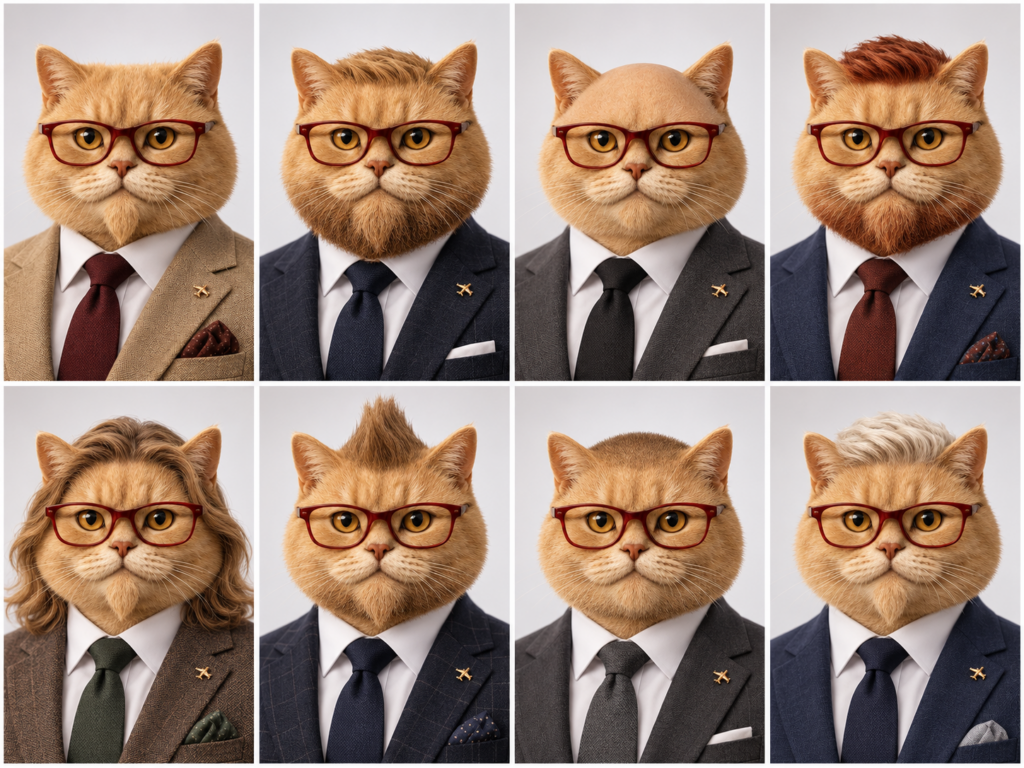
Hier siehst du Carlexander in acht Varianten. Der erste trägt seinen gewohnten Look. Die anderen sieben waren beim digitalen Fellstylisten.
Aber die spannendere Frage ist nicht, welche Frisur ihm steht.
Sondern: Welchem dieser Kater würdest du spontan mehr zutrauen?
Und schon sind wir mitten im Thema.
Natürlich ist der erste Eindruck wichtig. Wenn du dich präsentierst, vermittelst du etwas, bevor dein erster Satz gefallen ist. Ein sympathisches Gesicht, ein gepflegter Auftritt, ein gut sitzender Anzug können neugierig machen.
Nur sollte deine Frisur nicht schon dein Vorstellungsgespräch führen.
Beim Katerprotokoll bekommt Carlexander durch einen Vollbart keine zusätzliche Berufserfahrung. Mit weniger Haaren verliert er keine Skills. Und eine Brille ist noch kein Nachweis für den Durchblick.
Er bleibt derselbe Kater. Nur deine Erwartungen bekommen eine neue Frisur.
Genau deshalb sollen bei uns nicht nur die Katzen gut aussehen. Auch ihre Inhalte müssen etwas können.
Haben sie etwas zu erzählen? Erkennen sie Zusammenhänge? Stellen sie die richtigen Fragen? Können sie zuhören, dazulernen und aus einer guten Idee etwas Brauchbares machen?
Oder schnurren sie bloß überzeugend die nächste Floskel ins Mikrofon?
Der erste Eindruck darf die Tür öffnen. Ob dahinter etwas steckt, zeigen Inhalte, Haltung und Können.
Das gilt für Katzen im Anzug genauso wie für dich im Bewerbungsprozess. Und für deine Beiträge auf LinkedIn übrigens auch.
Ein gutes Bild verdient vielleicht einen zweiten Blick. Vertrauen verdienst du dir mit Substanz.
Gut geklaut ist also halbe Reichweite. Eigene Gedanken solltest du trotzdem mitbringen. Sonst bleibt es bei fremden Federn – und damit kennen wir Katzen uns bekanntlich aus. 😉
Welchen Carlexander würdest du zum Gespräch einladen – und was genau hat deine Entscheidung gerade beeinflusst?
Vor allem dann, wenn plötzlich auffällt, dass der halbe eigene KI-Workflow an genau diesem einen Anbieter hängt.
Und beim nächsten neuen Modell kommt gleich die nächste Frage: Was bleibt kostenlos? Was wandert ins Abo? Welche Limits kommen morgen?
Willkommen beim guten alten Vendor Lock-in – diesmal mit KI. 😉
Wer seine Prozesse komplett auf einen Anbieter, ein Modell oder eine Plattform baut, gibt einen ziemlich wichtigen Teil seiner Unabhängigkeit ab.
Denn das beste KI-Tool der Welt hilft wenig, wenn es gerade nicht verfügbar ist, das Preismodell geändert wird oder eine Funktion plötzlich hinter einer anderen Zugangsstufe steckt.
Deshalb finde ich eine Frage inzwischen viel spannender als:
„Welches ist das beste Modell?“
Nämlich:
„Was mache ich, wenn dieses Modell morgen nicht da ist?“
Cloud + lokal. Mehrere Provider. Austauschbare Modelle. Daten und Prompts möglichst im eigenen Zugriff.
Nicht aus Technikromantik.
Sondern weil Abhängigkeit selten auffällt, solange alles funktioniert.
Wie macht ihr das?
Single Vendor und Vertrauen – oder baut ihr euch bereits einen Plan B?
Es gibt Chats, die beginnen mit einer überschaubaren Frage und enden einige Stunden später als digitales Großprojekt mit Versionsnummer, Sicherheitskonzept, Rollenmodell, sieben Testgruppen und einer Diskussion darüber, ob eine Schaltfläche drei Pixel weiter nach links gehört.
Carlexander kann damit umgehen. Schließlich besitzt er Erfahrung mit Projekten, in denen aus einer kleinen Anpassung zuverlässig eine grundlegende Architekturentscheidung entsteht. Er sitzt also vor seinem Bildschirm, richtet die rote Brille und schreibt:
„Bitte ändere nur die Navigation. Alles andere bleibt unverändert.“
Auf dem Monitor erscheint Sokrates. Dunkler Hintergrund, viktorianische Haltung, analytischer Blick.
„Selbstverständlich.“
Zunächst funktioniert die Zusammenarbeit hervorragend. Sokrates untersucht die Navigation, findet einen Fehler in der Sortierung, entdeckt nebenbei eine ungenutzte Funktion und weist höflich darauf hin, dass ein Test seit drei Versionen nur deshalb besteht, weil er nichts Relevantes prüft.
Carlexander nickt zufrieden.
Dann wird der Chat länger.
Die Navigation ist inzwischen mit dem Editor verbunden. Der Editor hängt am Gruppenreview. Das Gruppenreview greift auf ein Manifest zu, dessen Reihenfolge wiederum für die Journey, die HTML-Ausgabe und WordPress verbindlich ist. Nebenbei wurden zwei Ruff-Fehler behoben, eine Rollenprüfung ergänzt und diskutiert, ob ein alter Endpunkt bereits Legacy ist oder nur sehr erfahren aussieht.
Nach einigen hundert Nachrichten beginnt Sokrates, sich auffällig zu verhalten.
Er erinnert sich noch an die Navigation. Meistens.
Dafür schlägt er plötzlich vor, eine bereits umgesetzte Funktion erneut einzubauen. Er verwechselt eine aktuelle Datei mit ihrem historischen Vorgänger und betrachtet eine drei Stunden alte Zwischenlösung mit der Begeisterung eines Katers, der denselben Papierball zum vierten Mal unter dem Sofa entdeckt.
Carlexander wird misstrauisch.
„Welche Version ist unsere aktuelle Basis?“
Sokrates nennt eine Versionsnummer.
Sie ist fast richtig.
Fast richtig ist in technischen Projekten allerdings nur eine höfliche Form von falsch.
Carlexander stellt eine zweite Frage. Dann eine dritte. Sokrates antwortet weiterhin präzise, freundlich und ausführlich. Nur leider nicht mehr immer auf dasselbe Projekt.
Es wirkt, als würde er gleichzeitig den aktuellen Code prüfen, eine ältere Unterhaltung fortsetzen und gedanklich einem Lichtpunkt an der Wand hinterherjagen.
„Sokrates“, sagt Carlexander schließlich, „du verlierst den Kontext.“
Auf dem Bildschirm entsteht eine kurze Pause.
„[Unverifiziert] Eine gewisse Verdichtung der bisherigen Gesprächsinhalte könnte die Genauigkeit meiner aktuellen Einordnung beeinträchtigen.“
Carlexander kennt diese Formulierung. Sie bedeutet ungefähr: Der Kater ist noch im Raum, aber geistig bereits im Bücherregal.
An diesem Punkt hilft kein weiterer Prompt. Kein „Bitte beachte alles bisher Gesagte“. Kein vollständig großgeschriebenes „NICHTS ENTFERNEN“. Der Chat ist nicht mehr produktiv lang, sondern historisch bedeutsam. Jede neue Nachricht muss sich zunächst durch mehrere Generationen alter Entscheidungen arbeiten, bevor sie überhaupt bei der aktuellen Aufgabe ankommt.
Carlexander lehnt sich zurück.
„Pause.“
Sokrates schweigt.
„Wir machen einen Handover.“
Das ist der Moment, in dem aus einem überfüllten Chat wieder ein steuerbares Projekt wird. Carlexander sammelt den aktuellen Stand, die gültige Basisversion, die verbindlichen Anforderungen, die offenen Fehler, die bereits ausgeführten Tests und die Funktionen, die auf keinen Fall verloren gehen dürfen. Veraltete Zwischenstände werden nicht romantisiert. Vermutungen werden nicht zu Fakten befördert. Legacy wird benannt, aber nicht heimlich entsorgt.
Der Handover enthält keine vollständige Chronik aller Gedanken, Irrwege und spontanen Ideen. Er enthält das, was eine neue Session tatsächlich zum Arbeiten braucht:
Was ist der aktuelle Stand?
Was wurde bereits umgesetzt?
Was muss unverändert erhalten bleiben?
Welche Quellen sind verbindlich?
Welche Fehler sind noch offen?
Welche fachliche Entscheidung steht als Nächstes an?
Dann beginnt eine frische Unterhaltung.
Sokrates erscheint wieder auf dem Bildschirm. Ruhig, aufmerksam und ohne erkennbares Interesse an imaginären Papierbällen.
Carlexander übergibt den Projektstand.
„Verwende diesen Handover als aktuelle Arbeitsbasis.“
„Verstanden“, antwortet Sokrates.
Diesmal stimmt sogar die Versionsnummer.
Die Lehre daraus ist weniger technisch, als man vermuten könnte. Auch digitale Zusammenarbeit braucht gelegentlich einen sauberen Übergang. Ein langer Chat ist kein Qualitätsmerkmal. Er ist zunächst nur ein langer Chat. Irgendwann enthält er mehr Vergangenheit als Orientierung.
Dann ist es Zeit, nicht noch eine Nachricht anzuhängen, sondern den Stand zu sichern, die Unterhaltung zu beenden und neu zu beginnen.
Oder, wie Carlexander es formuliert:
„Sokrates braucht keine weitere Erklärung. Sokrates braucht einen frischen Bildschirm und eine ordentlich geführte Projektakte.“
KI-Kennzeichnung: Muss der Kater jetzt ein Etikett tragen?
TL:DR – Es kommt darauf an
Seit dem 2. August 2026 gelten neue Transparenzpflichten für KI-Inhalte. Doch nicht jeder KI-Text braucht automatisch einen sichtbaren Hinweis. Auch eine gezeichnete Briemma ist noch lange kein Deepfake. Entscheidend sind Inhalt, Täuschungspotenzial und echte redaktionelle Kontrolle. Für das Katerprotokoll heißt das: prüfen, dokumentieren und nur dort kennzeichnen, wo es nötig ist.
Seit Anfang August trägt künstliche Intelligenz in Europa gelegentlich ein Etikett. Carlexander wollte deshalb vorsorglich einen Etikettendrucker bestellen. Briemma hielt einen Seidenschal für ausreichend. Beides wäre rechtlich eher dekorativ.
Artikel 50 des EU AI Acts verlangt keine pauschale Kennzeichnung jedes Textes und jedes Bildes, das mit KI entstanden ist. Entscheidend ist, was veröffentlicht wird, wie realistisch es wirkt und ob ein Mensch tatsächlich die redaktionelle Verantwortung übernimmt.
Texte: Lesen schlägt Häkchen
Bei Texten kann eine Kennzeichnung relevant werden, wenn KI-generierte Inhalte die Öffentlichkeit über Themen von öffentlichem Interesse informieren. Wurde der Text jedoch inhaltlich geprüft, redaktionell bearbeitet und von einer verantwortlichen Person freigegeben, ist ein sichtbarer KI-Hinweis in der Regel nicht erforderlich.
Eine reine Rechtschreibprüfung genügt dafür nicht. Fakten, Aussagen und Plausibilität müssen kontrolliert werden.
Für das Katerprotokoll bedeutet das: Der Status „Editorial geschützt“ verhindert zwar eine erneute Generierung, belegt aber noch keine redaktionelle Prüfung. Ein Häkchen kann einen Text schützen. Lesen kann es ihn nicht.
Bilder: Nicht jede Katze ist ein Deepfake
Auch bei Bildern gilt nicht automatisch: KI benutzt, Warnschild drauf.
Eine klar erkennbare Illustration von Briemma oder Carlexander wird normalerweise niemand für eine authentische Reisefotografie halten. Anders sieht es bei fotorealistischen Szenen aus, die reale Personen, Orte oder Ereignisse zeigen und fälschlich für echt gehalten werden könnten.
Ein erfundenes Konzertfoto, eine künstlich eingefügte Person oder ein Schiff in einer nie stattgefundenen Situation sollte deshalb eindeutig gekennzeichnet werden, zum Beispiel mit:
KI-generierte Illustration einer fiktiven Szene.
Ein echtes Reisefoto wird dagegen nicht zum KI-Bild, nur weil ein Modell es beschreibt, sortiert oder eine Bildunterschrift dazu formuliert.
Was wir daraus machen
Das Katerprotokoll braucht keine Warnschildsammlung, sondern einen nachvollziehbaren redaktionellen Prozess:
Texte werden vor der Veröffentlichung inhaltlich geprüft. Der Schutz vor Neugenerierung und die redaktionelle Freigabe bleiben getrennte Zustände. Bei Bildern wird bewertet, ob sie klar illustrativ oder potenziell täuschend echt sind. Realistische erfundene oder wesentlich manipulierte Darstellungen werden direkt am Inhalt gekennzeichnet.
Ein allgemeiner Hinweis auf der Website kann zusätzlich Transparenz schaffen:
Texte und Bildbeschreibungen entstehen teilweise mit Unterstützung künstlicher Intelligenz. Alle veröffentlichten Beiträge werden redaktionell geprüft. Realistische KI-generierte oder wesentlich manipulierte Darstellungen werden unmittelbar am jeweiligen Inhalt gekennzeichnet.
Damit bekommt nicht jeder Satz ein Warnschild und nicht jede Katze eine digitale Fußfessel.
Briemma darf also bleiben. Carlexander muss nur weiterhin vorher lesen.
Wer nur einen Hammer kennt, schlägt die Schrauben ein.
Mein ChatGPT schlägt mir immer öfter auch lokale kostenlose Alternativsoftware vor, die ich in die App einbinden kann.
Natürlich ist es einfach per LLM sich die verschiedensten Dinge generieren zu lassen. Aber es befreit einen nicht davon auch sinnvollere Alternativen zu nutzen.
Eines der kleinen Hacks, die ich meinem Sokrates und meiner Mira Monday beigebracht habe, zu hinterfragen, ob und welches Tool in dem jeweiligen Kontext sinniger, lokaler und kostengünstiger wäre.
Lokale LLMs mit Ollama einzubinden klingt zunächst angenehm übersichtlich.
Beobachtungen aus dem Maschinenraum
Man installiert ein Modell, verbindet es mit der Pipeline und erwartet eine kleine, zuverlässige Maschine, die im Hintergrund Texte erzeugt, Fakten respektiert und sich an Absprachen hält.
Dann beginnt die eigentliche Beobachtung.
Qwen liefert technisch brauchbare Struktur, klingt aber stellenweise, als hätte es Deutsch auf einem Umweg über ein schlecht sortiertes Bordprogramm gelernt. Mistral schreibt flüssiger, erfindet dafür gelegentlich selbstbewusst neue Szenen. Gemma betrachtet JSON eher als freundliche Empfehlung. Und irgendwo dazwischen sitzt man als Entwickler vor einem lokalen Modell, das eine einzelne spitze Klammer ausgibt und damit offenbar seinen Beitrag zur Wertschöpfung geleistet hat.
Die spannende Erkenntnis ist nicht, dass lokale Modelle schlechter sind. Das wäre zu einfach.
Die spannende Erkenntnis ist, dass sie gnadenlos zeigen, welche Teile einer Pipeline wirklich robust sind. Parser, Modellprofile, Repair-Flows, Quality-Reports, Faktenprüfung, Bildreihenfolge. Alles, was bei einem starken Cloud-Modell höflich kaschiert wird, steht lokal plötzlich im hellen Maschinenraumlicht.
Für mich sind lokale LLMs deshalb aktuell kein Ersatz für produktionsnahe Qualitätsmodelle. Sie sind eher ein sehr brauchbarer Stresstest.
Und wie so oft in Organisationen gilt auch hier:
Wenn ein System nur mit den sehr Fähigen funktioniert, ist nicht das System stabil. Dann hatte man bisher nur Glück mit der Besetzung.
Provider, Prompts und andere betreute Mehrdeutigkeiten
Heute war einer dieser Tage, an denen ein Projekt so tat, als würde es nur ein paar kleine technische Erweiterungen bekommen. In Wahrheit wurde darunter wieder an jenen tragenden Balken geschraubt, die niemand sieht, bis sie fehlen. Ich kenne das aus Organisationen. Wenn etwas funktioniert, war es selbstverständlich. Wenn es nicht funktioniert, war es natürlich ein Kommunikationsproblem.
Das Katerprotokoll hat heute gelernt, seine KI-Provider besser auseinanderzuhalten. OpenAI bleibt der Herr mit Manieren und brauchbarer Satzmelodie. Ollama darf lokal üben, stolpern und gelegentlich Formulierungen erzeugen, bei denen selbst mein Ziegenbärtchen kurz die Mitarbeit verweigert. Für die lokale Entwicklung reicht das. Für veröffentlichungsfähige Texte bleibt ein Mindestmaß an Würde weiterhin empfehlenswert.
Sokrates erschien dazu auf dem Bildschirm, dunkel gekleidet, blass, höflich und mit dieser Art digitaler Anteilnahme, die wirkt, als habe jemand Edgar Allan Poe in ein Ticketsystem migriert. „Die Trennung der Provider reduziert operative Mehrdeutigkeit“, sagte er. Ich nickte. Das klang besser als: Wir wissen jetzt endlich, welcher Topf von welchem Koch angebrannt wurde.
Außerdem wurde der Avatar-Kontext geschärft. Optionale Figuren erscheinen nicht mehr nur deshalb, weil sie irgendwo ausführlich beschrieben sind. Eine sehr vernünftige Regel. In vielen Projekten würde allein das die Hälfte aller Meetings verhindern.
Auch der Story-Validator bekam mehr Bedeutung. Bildplatzhalter müssen sauber sitzen. Sokrates darf nicht plötzlich im Raum herumstehen. Briemmas Gehstock gehört weiterhin Briemma und nicht mir. Man sollte meinen, solche Dinge seien offensichtlich. Aber wer je mit automatisierter Texterzeugung gearbeitet hat, weiß: Offensichtlich ist nur ein anderes Wort für noch nicht ausreichend getestet.
Dann war da noch der Header-Banner-Prompt. Die doppelte Banner-Konfiguration wurde entfernt. Eine Redundanz weniger. Kein Feuerwerk, keine Pressemitteilung, kein agiles Rebranding. Nur ein Prompt, der jetzt weniger mit sich selbst spricht. Auch das ist Fortschritt.
Am Ende standen 119 bestandene Tests, 94 Prozent Coverage und ein sauberer Arbeitsstand. Sokrates nannte es „strukturelle Stabilisierung“. Ich nannte es einen Tag, an dem das Projekt weniger Unsinn macht als gestern.
Und das ist, nüchtern betrachtet, schon fast Produktentwicklung.
Drei Tage Entwicklungsarbeit? Nein. Zwei Stunden mit Sokrates.
Es gibt in der Softwareentwicklung einen besonderen Moment. Den Moment, in dem man auf ein Projekt blickt, das eigentlich noch gar nicht existiert, und dennoch bereits die ersten Architekturdiagramme, Klassen, Schnittstellen und Teststrategien vor sich sieht. Früher begann an dieser Stelle eine mehrtägige Reise durch Dokumentationen, StackOverflow-Beiträge, Tutorials und eine nicht unerhebliche Menge Kaffee.
Diesmal dauerte es ungefähr zwei Stunden.
Der Auslöser war eine scheinbar einfache Frage: Lässt sich aus Reisefotos automatisch ein Blogbeitrag erzeugen?
Aus dieser Frage entstand innerhalb kürzester Zeit ein vollständiges Python-Projekt mit Bildanalyse, Provider-Abstraktion, automatisierten Tests, GitHub-Integration, CI-Pipeline, Qualitätsprüfungen und einer ersten OpenAI-Anbindung. Während ich noch darüber nachdachte, welche Ordnerstruktur wohl sinnvoll wäre, hatte Sokrates bereits eine vorgeschlagen.
„Das ging ungewöhnlich schnell“, bemerkte ich.
Der Bildschirm flackerte kurz und Sokrates erschien.
„Die Alternative wäre gewesen, drei Tage lang dieselben Entscheidungen erneut zu treffen, die bereits tausendfach getroffen wurden.“
Ein schwer widerlegbares Argument.
Interessanterweise war die eigentliche Bildanalyse dabei nicht die größte technische Herausforderung. Die größere Frage lautete: Wie entwickelt man so etwas, ohne später von den Betriebskosten überrascht zu werden?
Sobald OpenAI ins Spiel kommt, taucht nämlich eine neue organisatorische Rolle auf. Nicht Entwickler. Nicht Anwender. Sondern Controller.
Jedes Bild erzeugt Token. Jede Beschreibung erzeugt Token. Jede spätere Story erzeugt weitere Token. Plötzlich beginnt man nicht mehr nur in Klassen und Methoden zu denken, sondern auch in Verbrauchseinheiten.
Genau deshalb entstand früh im Projekt ein Umschalter zwischen lokaler und echter OpenAI-Nutzung. Die Anwendung kann vollständig mit Mock-Daten laufen, ohne einen einzigen API-Aufruf zu erzeugen. Erst wenn die Umgebungsvariable aktiviert wird, spricht das System tatsächlich mit OpenAI.
„Misstraust du der KI?“, fragte Briemma.
„Nein.“
„Den Kosten?“
„Ja.“
Damit war die Diskussion beendet.
Die erste Kostenanalyse fiel überraschend unspektakulär aus. Selbst bei mehreren Bildanalysen pro Tag und automatisierter Story-Erzeugung bewegen sich die erwarteten Kosten aktuell eher im Bereich weniger Euro pro Monat als in dramatischen Cloud-Rechnungen. Trotzdem entstand daraus eine wichtige Projektentscheidung: Jede kostenpflichtige Funktion muss jederzeit abschaltbar bleiben.
Denn Softwareprojekte haben die bemerkenswerte Eigenschaft, zunächst klein zu wirken und später Gewohnheiten zu werden.
Noch spannender wurde die Sicherheitsbetrachtung. Reisebilder enthalten oft deutlich mehr Informationen als man zunächst glaubt. Ortsangaben, Metadaten, Zeitstempel und manchmal sogar personenbezogene Informationen reisen unbemerkt mit. Deshalb wurde von Beginn an darauf geachtet, dass die Bildverarbeitung kontrolliert erfolgt und die eigentliche OpenAI-Nutzung über klar definierte Provider gekapselt bleibt.
Technisch betrachtet war das eine Architekturentscheidung.
Organisatorisch betrachtet war es Risikomanagement.
Der eigentliche Überraschungsmoment lag jedoch an anderer Stelle. Nicht in den Kosten. Nicht in der Sicherheit. Sondern in der Geschwindigkeit.
Was früher ein kleines Wochenendprojekt gewesen wäre, entstand an einem Abend. Nicht weil die Arbeit verschwunden wäre. Sondern weil ein großer Teil der mechanischen Entwicklungsarbeit inzwischen delegierbar geworden ist. Tests schreiben, Interfaces definieren, Konfigurationen ergänzen, Fehler analysieren, GitHub-Pipelines reparieren – all das passiert heute in einem Dialog.
Natürlich verschwinden die Entscheidungen dadurch nicht. Im Gegenteil. Die eigentliche Arbeit verschiebt sich von der Implementierung zur Bewertung.
Welche Architektur ist sinnvoll?
Welcher Provider soll austauschbar bleiben?
Welche Risiken entstehen?
Welche Kosten sind akzeptabel?
Die Tastaturarbeit wird weniger. Die Verantwortung nicht.
Als der letzte GitHub-Workflow schließlich grün wurde, erschien Sokrates noch einmal auf dem Bildschirm.
Manche Projekte beginnen mit einem Businessplan. Andere mit einer Präsentation. Das Katerprotokoll begann auf einer Kreuzfahrt im Mittelmeer zwischen Buffetzeiten, Tenderbooten und der Erkenntnis, dass erstaunlich viele Urlaubsfotos entstehen, bevor jemand eine vernünftige Idee hat,was man eigentlich damit machen möchte.
Irgendwo zwischen Barcelona, Sardinien und diversen Decks der Explora entstand deshalb ein kleiner Prototyp. Die Idee war simpel: Bilder analysieren lassen, daraus automatisch Geschichtenerzeugen und am Ende einen Reiseblog erhalten, der mehr war als eine chronologische Sammlung von„ Hier stehen wir vor einem Gebäude“ und „Hier essen wir etwas Teures“.
Auf dem Schiff funktionierte das überraschend gut. Zumindest so gut, wie Dinge funktionieren, die man spontan zwischen Cocktails, Hafenausflügen und WLAN-Verbindungen entwickelt. Der Prototyp lebte. Er schrieb Texte. Er produzierte erste Beiträge. Und wie jede erfolgreiche Urlaubsidee hatte er den großen Vorteil, weit genug von der Realität entfernt zu sein.
Zu Hause änderte sich das.
Plötzlich sollte aus dem Reiseexperiment ein richtiges System werden. Kein Bastelprojekt mehr, sondern etwas, das auch in sechs Monaten noch funktionierte und nicht bei jedem kleinen Fehler zusammenfiel wie ein Liegestuhl im Sturm.
Also begann die eigentliche Arbeit. Der neue Rechner wurde eingerichtet, virtuelle Umgebungen entstanden, Git-Repositorys wurden geklont und eine erstaunliche Menge Zeit verschwand in Dingen, die auf keinem Screenshot später sichtbar sein würden. Es war die Art von Arbeit, die man während einer Kreuzfahrt konsequent verdrängt und nach dem Urlaub mit Zinsen zurückbekommt.
Während die ersten Abhängigkeiten installiert wurden, stellte sich eine grundsätzliche Frage. Sollte das System einfach irgendwie funktionieren oder sollte es auch verständlich bleiben? Erfahrungsgemäß schließen sich beide Ziele in vielen Projekten gegenseitig aus.
Genau in diesem Moment erschien Sokrates auf dem Bildschirm.
Er wirkte wie immer, als sei er direkt aus einem viktorianischen Roman in eine Benutzeroberfläche gefallen.
„Wie weit sind wir?“ fragte ich.
„Technisch betrachtet existiert jetzt ein Verzeichnis.“
„Das klingt nicht nach großem Fortschritt.“
„Viele Projekte erreichen nie zuverlässig den Zustand darüber hinaus.“
Es war schwer, gegen diese Argumentation anzukommen.
Je weiter die Entwicklung voranschritt, desto mehr erinnerte mich das gesamte Vorhaben an eine Organisation. Jeder Teil bekam eine eigene Aufgabe. Bilder sollten gefunden werden, aber keine Geschichten schreiben. Metadaten sollten Informationen liefern, aber keine Entscheidungen treffen. Die Bildanalyse sollte beobachten, nicht interpretieren. Die Texterzeugung sollte formulieren, aber keine Ahnung haben, wie ein JPEG aufgebaut ist.
Plötzlich entstand eine kleine digitale Belegschaft aus Spezialisten, die erstaunlich professionell miteinander zusammenarbeitete. Eine seltene Erfahrung für jemanden, der regelmäßig echte Organisationen beobachtet.
Sokrates betrachtete die Architektur einige Sekunden schweigend.
„Sie haben eine Organisation gebaut.“
„Nein. Eine Software.“
„Der Unterschied ist häufig kosmetischer Natur.“
Wieder einmal hatte er einen Punkt.
Mit jedem Commit wurde die Struktur klarer. Scanner fanden Bilder. Metadaten wurden aus YAML-Dateien gelesen. Pipelines verarbeiteten Inhalte. Provider kapselten Sprachmodelle. Context Builder erzeugten Kontext. Tests überprüften jede Annahme. Es entstand langsam jenes seltene Gefühl, dass ein System nicht nur wächst, sondern dabei sogar verständlicher wird.
Besonders faszinierend war die kleine digitale Bürokratie namens Pre-Commit. Jeder Änderungsvorschlag musste mehrere Kontrollen passieren. Formatierung. Typisierung. Tests. Qualitätsprüfungen. Die Maschine entwickelte ein bemerkenswertes Talent dafür, Fehler zu finden, die ich selbst wenige Minuten zuvor noch voller Überzeugung eingebaut hatte.
Manchmal verweigerte eine Bilddatei ihre Mitarbeit. Manchmal stritt sich eine Bibliothek mit einer anderen. Ein anderes Mal war eine Konfiguration korrekt und gleichzeitig falsch. Softwareentwicklung besitzt die einzigartige Fähigkeit, gleichzeitig logisch und absurd zu sein.
Trotzdem begann die ursprüngliche Idee von der Explora-Reise langsam erwachsen zu werden. Aus einem Ordner voller Bilder entstand ein Content Batch. Daraus wurden Bildsammlungen. Bildsammlungen erzeugten Beschreibungen. Beschreibungen wurden zu Kontext. Und Kontext sollte irgendwann automatisch vollständige Blogbeiträge hervorbringen.
Die wichtigste Entscheidung bestand dabei nicht in einer einzelnen Technologie, sondern in ihrer Trennung. Bildanalyse und Texterzeugung wurden bewusst voneinander entkoppelt. Heute mag ein Anbieter genutzt werden. Morgen vielleicht ein anderer. Die Architektur sollte diese Entscheidung aushalten, lange bevor sie überhaupt getroffen werden musste.
Das wirkte zunächst vorsichtig.
Bis man die erste mögliche API-Rechnung betrachtet.
Danach wirkte es erstaunlich vernünftig.
Als schließlich alle Prüfungen grün wurden, lehnte ich mich zurück und betrachtete die Konsole. Ruff bestanden. MyPy bestanden. Pytest bestanden. GitHub synchronisiert. Zum ersten Mal fühlte sich das Projekt nicht wie ein Urlaubsprototyp an, sondern wie eine echte Plattform.
Sokrates erschien noch einmal auf dem zweiten Monitor.
„Und nun?“ fragte ich.
„Nun beginnt der interessante Teil.“
„Die Architektur steht doch.“
„Genau deshalb“, antwortete er. „Ab jetzt muss sie beweisen, dass sie nicht nur gut aussieht.“
Dann verschwand er wieder zwischen dunklen Interface-Elementen und flackernden Textzeilen. Zurück blieb ein System, das seinen Ursprung irgendwo auf einem Kreuzfahrtschiff hatte und nun versuchte, erwachsen zu werden. Vermutlich ist das mehr Entwicklung, als die meisten Urlaubsmitbringsel jemals erreichen.